1番に手を挙げること
最初に何か意見を言う事はとても大切
初めに質問をすれば次の人が続きやすく
バカな質問をすれば質問するハードルが下がり発言が増え
関係ない質問をすれば話が広がる
1番最初に手を挙げる人が1番偉い
批判は誰でもできる
google cloud セマンティック検索
google cloud のセマンティック検索を使ってみたい
詳しい内容は google cloud の 動画から www.youtube.com
テキスト検索ではなく、ベクトル検索になるので、いい感じで検索結果をかえしてくれるらしい また、マルチモーダルのため画像、音声なども扱える。 今回は 画像を google cloud storage に置き、セマンティック検索を試してみたい。

まずは、画像データの準備から
機械学習の無料のサンプルデータセットを利用した。 ここには 30枚の部屋の写真がのっている。 それぞれ、雰囲気や映しているものも異なる。 ローカルに一度保存。
cloud storage に 画像アップロード
これを google cloud storage に配置する。 ちなみに、google cloud のアカウントは最初に無料枠として $300 が使えるため、 どれくらい費用としてかかるのかも見てみたい。 バケットを作成し、準備した画像をアップロード
次に、Bigquery に オブジェクトテーブルを作成する
これ以降は google cloud のチュートリアルを参考にした。 https://cloud.google.com/blog/products/data-analytics/bigquery-multimodal-embeddings-generation/?hl=en
まずは画像データを扱う為のオブジェクトテーブルを作る。 オブジェクトテーブルとは非構造化データを扱う為の、読み取り専用テーブル https://cloud.google.com/bigquery/docs/object-table-introduction?hl=ja
チュートリアルには書かれていないが、コンソールから コネクションの作成が必要。
下記を参考にして、コネクションを作成する。 bk mk --connection コマンドで作るらしい。 zenn.dev
コネクション作成後、適宜下記の内容を書き換えて、create。 connectionId は先程作ったものを指定する。
CREATE OR REPLACE EXTERNAL TABLE
`bqml_tutorial.met_images`
WITH CONNECTION `Location.ConnectionID`
OPTIONS
( object_metadata = 'SIMPLE',
   uris = ['gs://gcs-public-data--met/*']
);
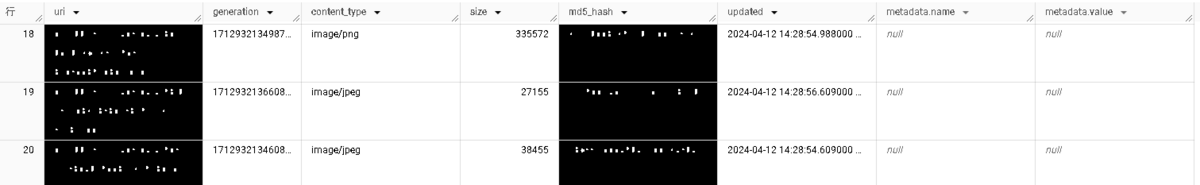
無事、テーブルは作成できたが、select が permission denied のエラー storage.objects.list の権限がなさそう。
Bigquery の サービスアカウントに対して、IAM と管理の画面から プリンシパルに Bigquery のサービスアカウント、ロールに、Storage オブジェクト閲覧者を付与して再実行。
無事、見えてきた。
モデルを作成する。
※これ以降のソースコードはサンプルをそのまま貼り付けている。 適宜、プロジェクト名など変更する必要があり。
CREATE OR REPLACE MODEL
 bqml_tutorial.multimodal_embedding_model REMOTE
WITH CONNECTION `LOCATION.CONNNECTION_ID`
OPTIONS (endpoint = 'multimodalembedding@001')
マルチモーダルだと、endpoint は 上記を使うらしい?
エンベディングを生成する
CREATE OR REPLACE TABLE `bqml_tutorial.met_image_embeddings`
AS
SELECT * FROM ML.GENERATE_EMBEDDING(
  MODEL `bqml_tutorial.multimodal_embedding_model`,
  TABLE `bqml_tutorial.met_images`)
WHERE content_type = 'image/jpeg'
Limit 10000
作った、テーブルとモデルを使用して、エンベディングをつくる。 また権限のエラー
gserviceaccount.com does not have the permission to access resources used by ML.GENERATE_EMBEDDING.
エラーメッセージで下記を参照して、権限付与しろとのこと Vertex AI ユーザーを付与すればよさそう → ダメだった。よくわらないかつ面倒なので vertex AI の 管理者ロールを与えた。 最小権限の原則とかから本来は調べるべき。実行できた ok https://cloud.google.com/bigquery/docs/generate-text-tutorial?hl=ja
生成されたエンベディングにベクトルインデックスを作成する
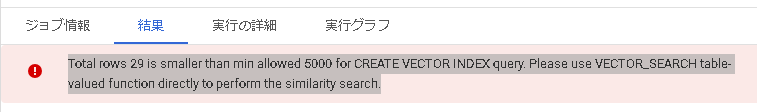
CREATE OR REPLACE VECTOR INDEX  `met_images_index`
ON bqml_tutorial.met_image_embeddings(ml_generate_embedding_result)
OPTIONS(index_type = 'IVF',
 distance_type = 'COSINE')
どうやら合計行数は最低でも 5000 行必要らしい。
まぁ、ベクトルインデックスは、オプションらしいので今回はとばす。
テキストから画像への (クロスモダリティ) 検索に埋め込みを使用する
-- embed search string

CREATE OR REPLACE TABLE `bqml_tutorial.search_embedding`
AS
SELECT * FROM ML.GENERATE_EMBEDDING(
  MODEL `bqml_tutorial.multimodal_embedding_model`,
  (
    SELECT "pictures of white or cream colored dress from victorian era" AS content
  )
)
これで、埋め込まれた検索文字列を使用して、 類似した埋め込みを検索できるようになった。
-- use the embedded search string to search for images

CREATE OR REPLACE TABLE
 `bqml_tutorial.vector_search_results` AS
SELECT
 base.uri AS gcs_uri,
 distance
FROM
 VECTOR_SEARCH( TABLE `bqml_tutorial.met_image_embeddings`,
   "ml_generate_embedding_result",
   TABLE `bqml_tutorial.search_embedding`,
   "ml_generate_embedding_result",
   top_k => 5)
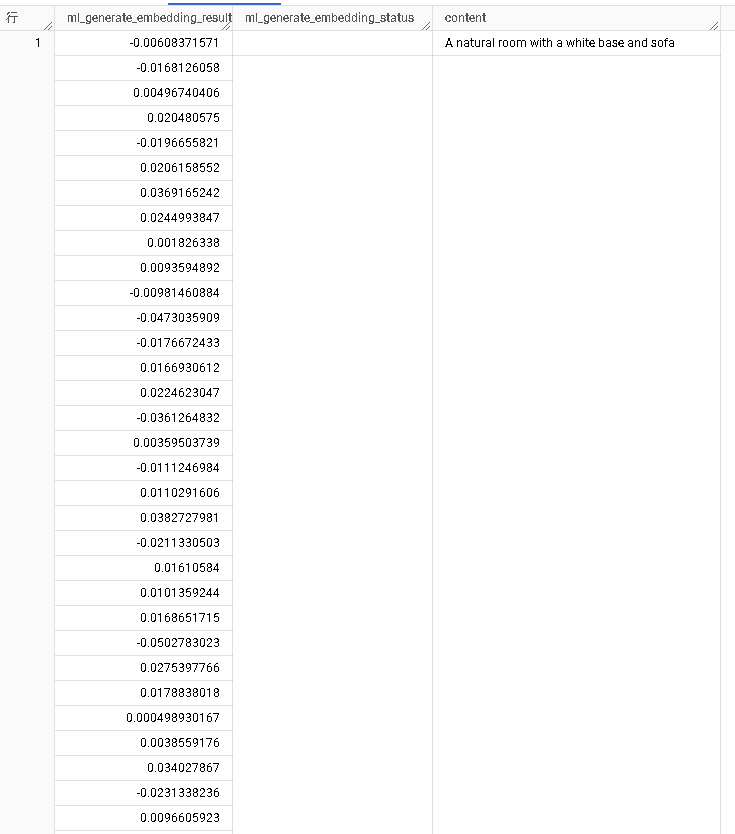
ちなみに、自分は 部屋の写真を読み込み、
CREATE OR REPLACE TABLE `first-study-project-414006.bgml_turorial.room_search_embeddings`
AS
SELECT * FROM ML.GENERATE_EMBEDDING(
  MODEL `first-study-project-414006.bgml_turorial.room_model`,
  (
    SELECT "A natural room with a white base and sofa" AS content
  )
)
このような埋め込みを使用した。 create されたテーブルはこのように、embedding された結果が格納されている。
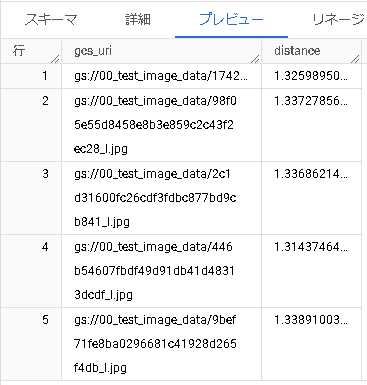
-- use the embedded search string to search for images

CREATE OR REPLACE TABLE
 `first-study-project-414006.bgml_turorial.room_search_results` AS
SELECT
 base.uri AS gcs_uri,
 distance
FROM
 VECTOR_SEARCH( TABLE `first-study-project-414006.bgml_turorial.room_embeddings`,
   "ml_generate_embedding_result",
   TABLE `first-study-project-414006.bgml_turorial.room_search_embeddings`,
   "ml_generate_embedding_result",
   top_k => 5)
結果と cloud storage に格納されている画像見てみましたが、 だいぶ良さそうでした。もう少し調べてみます。
ノートパソコンの Out of Memory
大学時代から、約6年ほど使っているノートパソコンが
ブラウザを複数立ち上げていると、
エラー : Out of Memory となってしまう。
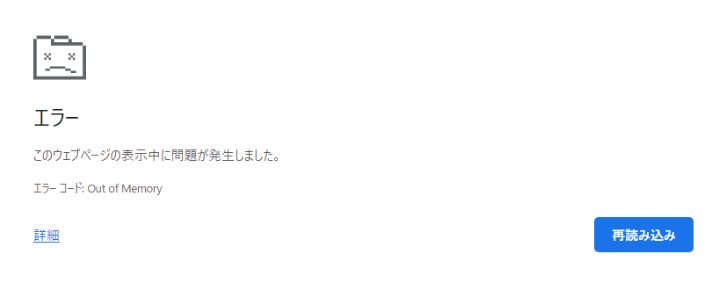
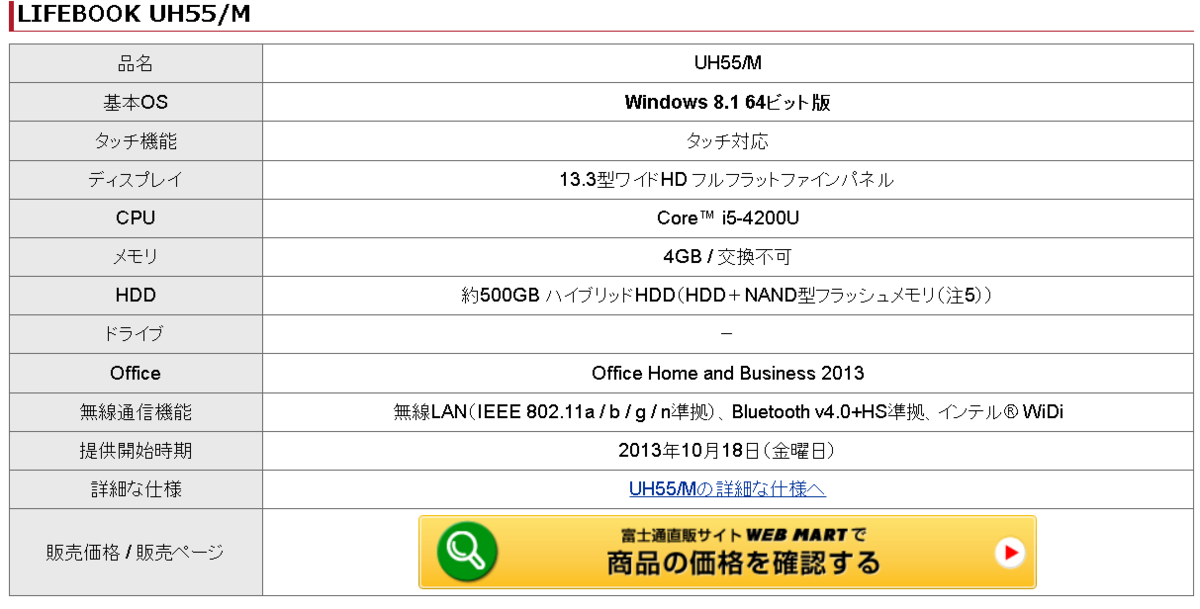
使用してるPC の情報としては下記。
タスクマネージャーを確認し、メモリの使用状況を確認すると、
4GB ぎりぎりをさまよってるので、交換してみようと思った。
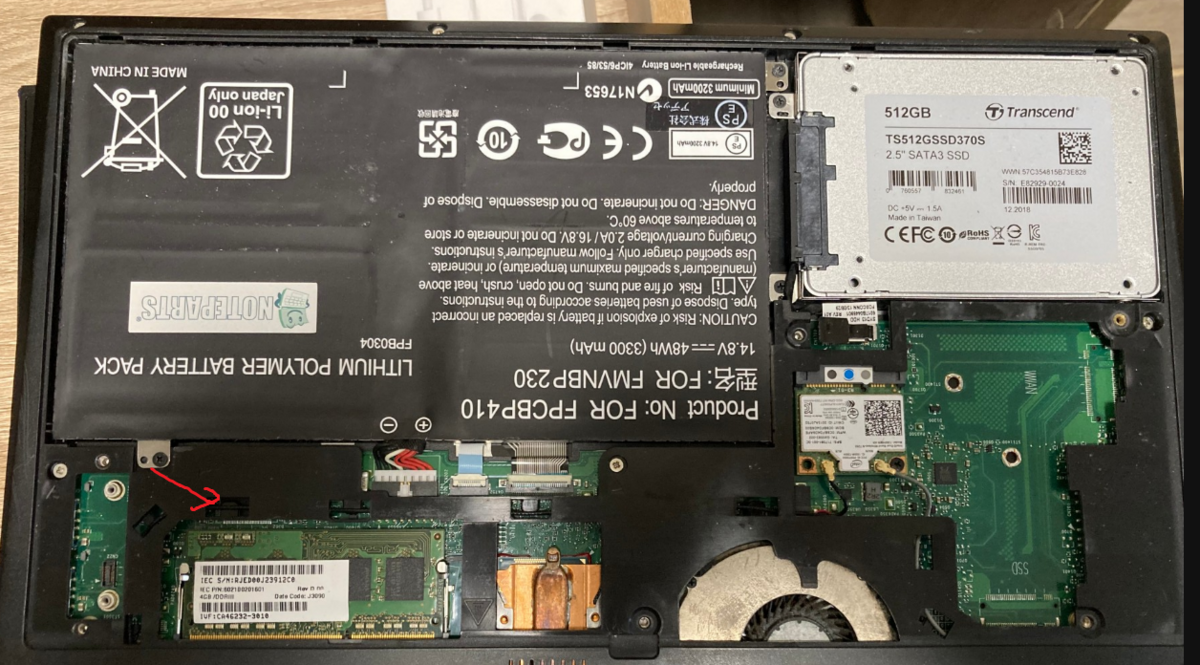
この左下のところがメモリ。ちなみに右上の SSD だが、大学時代にHDDから交換した。
購入したメモリは、DDR3L の 8GB
2000円もせず、購入できた。
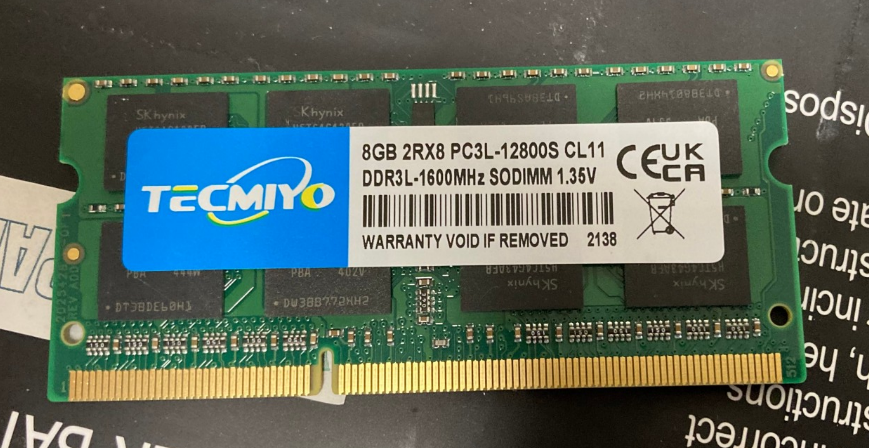
メモリを入れ替えると、ブラウザでの動作も問題なく

8.00 GB で認識。

使用状況も余裕のある感じ。
問題なさそう。
AWS CodeWhisperer を VScode で使ってみた使用感
はじめに
Amazon CodeWhisperer という IDE 上で、
コメントを書くとコードを提案してくれるという
とても便利な機能があることを知った。
ちょうど、機械学習を学ぶ為にPythonを学びたいという気持ちがあったので
使ってみようと思った。
AWS の CodeWhisperer の ページを見てみるとなんと…
生産性が 57% 迅速化。かつ、27% 正常にタスクを完了できる可能性が高くなるらしい。

インストール方法
インストール方法はとても簡単で、まずIDEをインストールする。
現在対応しているのは、
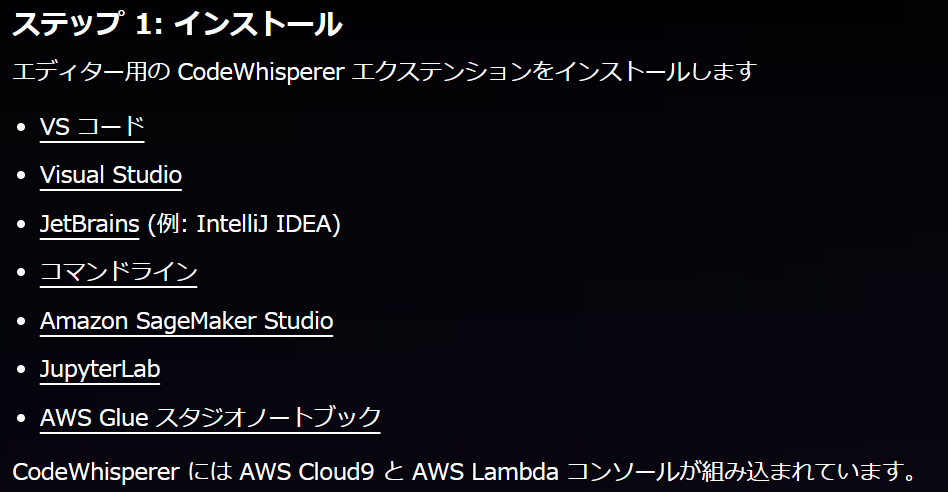
今回は VSCode で使ってみる。
VSCode をインストール後は、下記のサイトを参考に
インストール作業を進めた。
Amazon CodeWhisperer を VSCode に導入してみた! | cloud.config Tech Blog
ものの数分でインストールができた。
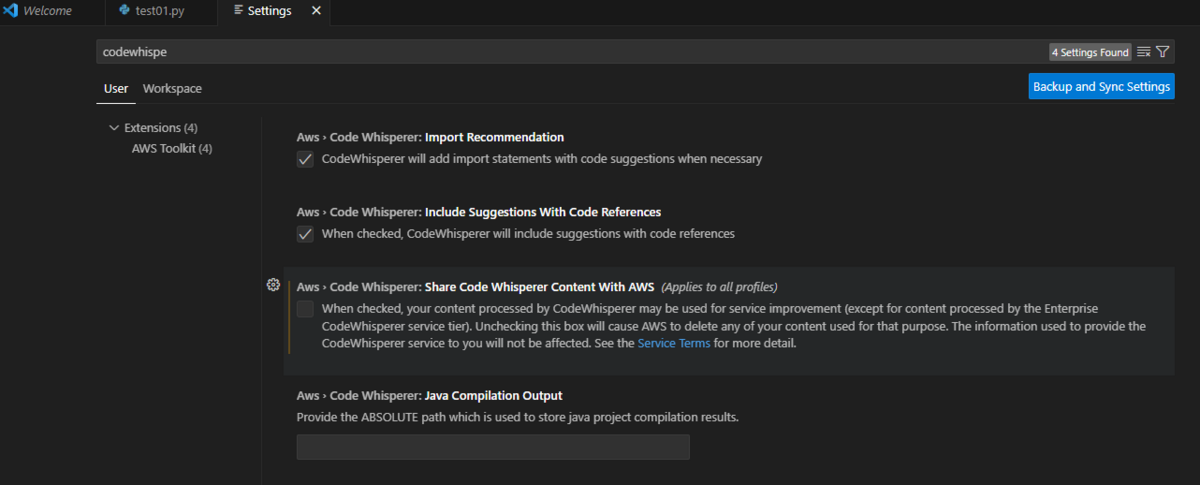
コードを生成するために使用したコメントを収集しているそうなので、
SettingでCodeWhispererと検索し、
「Sharing Code Whisperer Content With AWS」のチェックを外した
Python 3.12.0 のインストール
こちらのサイトを参考に、インストール
pandas が使えなかったので ターミナルで
pip install pandas
使用方法
・コードの提案:Windows「Alt+C」
・次の候補を提案:→キー or ←キー
・提案されたコードの採用:Tabキー
Alt + C で コードを提案してもらい

よさそうなら、Tabキーで決定

試しに、こちらの本の1章を少しやってみる
1つずつのファイルを見てみようと思ったときにcsv ファイルを配置している
CSV フォルダ配下に存在しない order_master.csv を読み込むような提案をされた。
ただ、order_master.csv は存在しないので、customer_master.csv、item_master.csv に
基づいて、予測してくれたのだと思う。

ある程度、コメントに書いてくれたことを理解して
コードを提案してくれる。
ものの15分くらいで、1章の内容のコーディングと
グラフの可視化までたどり着けた。
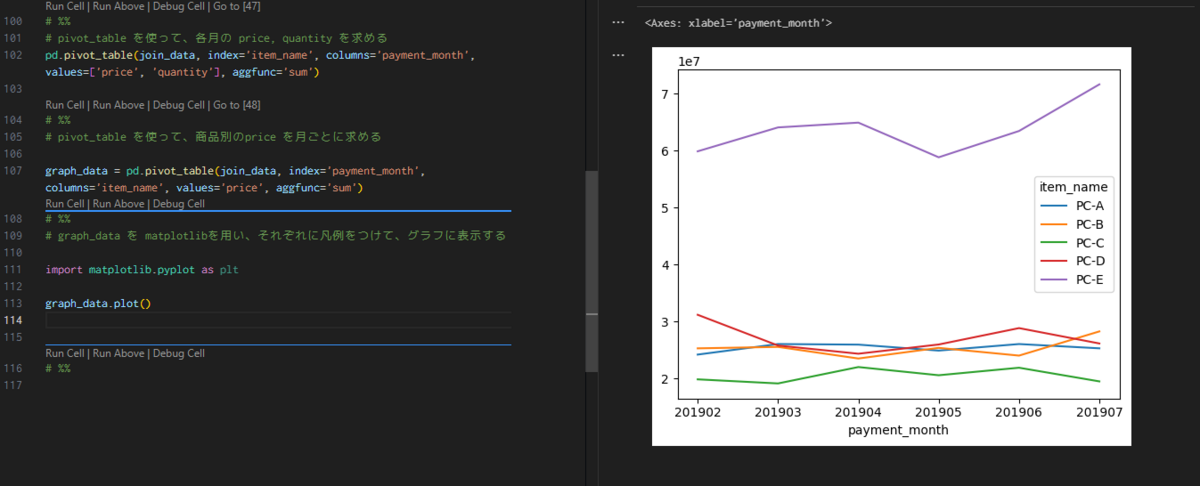
コメントを書けば、ある程度、コードを提案してくれるため
ほとんど自分でコードを修正することはなかった。
今回は、参考書もあったため、正しそうか確認もできたことが大きい。
今後は、この CodeWhisperer を活用しながら
他の言語も対応しているそうなので、色々やってみたい。

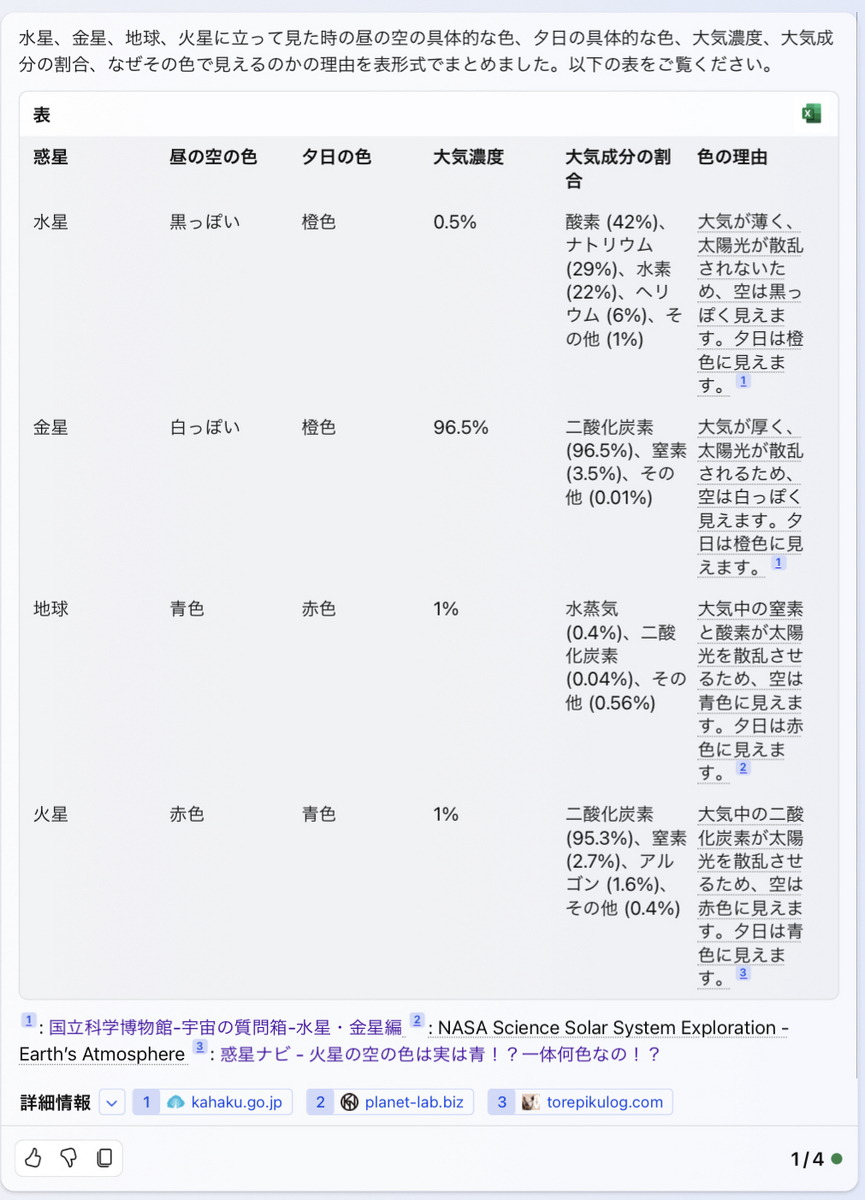
火星の夕焼けは青いらしい
ふと、太陽系の他の惑星で、空を見上げた時に
昼間、夕焼けでどんな色をしてるのか気になった。
流行りのBing AI に聞いてみたら、面白かった。
違う箇所もあるかもしれないが以下が回答。


終わりを思い描くことから始める (7つの習慣)
自分の葬式を想像し、そこに参列してくれる人のこと、そこで読まれる弔辞の文章をリアルにイメージして欲しい。終わりを思い描くことで自分がどう生きるべきなのか、本当の成功の定義が見えてくる。すべてのものは2度作られる 第一の創造はまず思い描くこと、第二の創造は実際に思い描いたものを作ること。第一の想像がなければ実際に実現されることはない。まずは思い描くことから、そのためには終わりを思い描くことが重要である。
